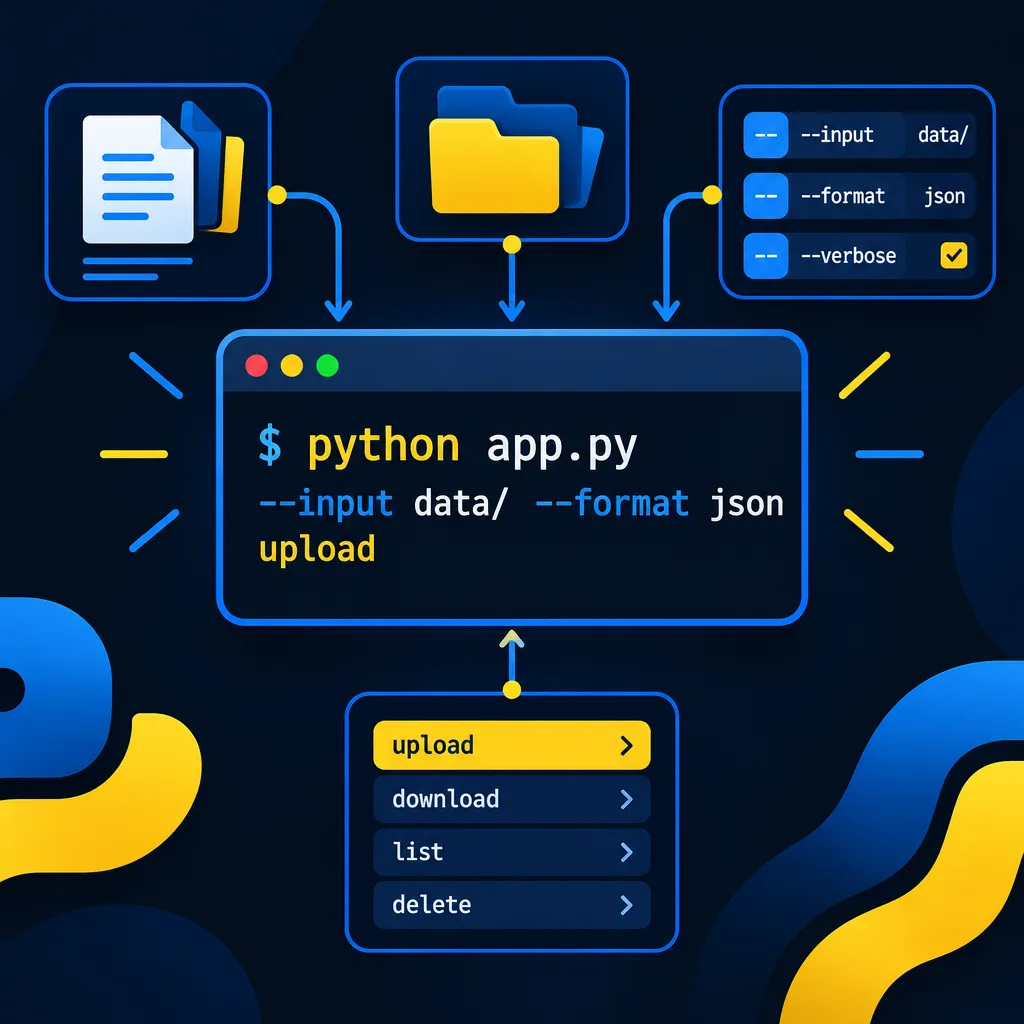
Un script deja de ser cómodo cuando necesitas abrirlo cada vez que quieres cambiar una ruta, activar una opción o seleccionar la operación que debe ejecutar. Una interfaz de línea de comandos evita ese problema: los datos variables llegan desde la terminal y el código conserva la lógica que quieres reutilizar.
Vamos a crear una utilidad llamada archivo_cli.py con dos subcomandos: uno para analizar los archivos de un directorio y otro para clasificar un archivo según su extensión. La estructura puede adaptarse después a conversores, copias de seguridad, organizadores de archivos o herramientas de administración.
La solución utiliza argparse para interpretar la línea de comandos y pathlib para representar rutas. Ambos módulos pertenecen a la biblioteca estándar. La documentación oficial de argparse explica que ArgumentParser reúne las especificaciones de los argumentos, genera ayuda y detecta invocaciones no válidas. Por su parte, pathlib ofrece objetos para trabajar con rutas de acuerdo con el sistema donde se ejecuta el programa.
Diseñar el comando antes de programarlo
Antes de llamar a add_argument(), conviene definir el contrato de la herramienta: qué operaciones ofrece, qué datos son imprescindibles, qué opciones modifican el comportamiento y qué resultado produce.
python archivo_cli.py analizar ./documentos
python archivo_cli.py analizar ./documentos --recursive
python archivo_cli.py analizar ./documentos --extension pdf --json
python archivo_cli.py clasificar ./documentos/informe.pdf- Programa:
archivo_cli.py. - Subcomando:
analizaroclasificar. - Argumento posicional: la ruta necesaria para ejecutar la operación.
- Opciones:
--recursive,--extensiony--json.
Qué elemento utilizar en cada caso
| Necesidad | Elemento | Ejemplo | Consecuencia |
|---|---|---|---|
| Dato imprescindible y fácil de identificar | Argumento posicional | analizar DIRECTORIO | La orden es corta, pero la posición importa. |
| Valor opcional o configurable | Opción con valor | --extension pdf | El nombre explica qué representa el valor. |
| Activar un comportamiento | Flag | --recursive | No necesita recibir un texto adicional. |
| Elegir entre operaciones diferentes | Subcomando | analizar o clasificar | Cada operación dispone de sus propios argumentos. |
No conviene convertir todos los datos en posiciones. Una orden como programa carpeta pdf true obliga a recordar qué significa cada valor. programa analizar carpeta --extension pdf --recursive es más larga, pero también más comprensible.
Herramienta completa con argparse y pathlib
Crea un archivo llamado archivo_cli.py con este contenido:
import argparse
import json
import sys
from collections import Counter
from pathlib import Path

CATEGORIES = {
    ".jpg": "imagenes",
    ".jpeg": "imagenes",
    ".png": "imagenes",
    ".gif": "imagenes",
    ".pdf": "documentos",
    ".txt": "documentos",
    ".docx": "documentos",
    ".xlsx": "documentos",
    ".csv": "datos",
    ".json": "datos",
    ".py": "codigo",
    ".js": "codigo",
    ".html": "codigo",
    ".css": "codigo",
    ".zip": "comprimidos",
    ".tar": "comprimidos",
    ".gz": "comprimidos",
}


def checked_path(value: str, expected: str) -> Path:
    path = Path(value).expanduser()

    try:
        if not path.exists():
            raise argparse.ArgumentTypeError(
                f"la ruta no existe: {path}"
            )
        if expected == "file" and not path.is_file():
            raise argparse.ArgumentTypeError(
                f"la ruta no es un archivo: {path}"
            )
        if expected == "directory" and not path.is_dir():
            raise argparse.ArgumentTypeError(
                f"la ruta no es un directorio: {path}"
            )
    except OSError as error:
        raise argparse.ArgumentTypeError(
            f"no se puede consultar la ruta {path}: {error}"
        ) from error

    return path


def existing_file(value: str) -> Path:
    return checked_path(value, "file")


def existing_directory(value: str) -> Path:
    return checked_path(value, "directory")


def extension_value(value: str) -> str:
    cleaned = value.strip().lower()
    if not cleaned:
        raise argparse.ArgumentTypeError(
            "la extensión no puede estar vacía"
        )
    return cleaned if cleaned.startswith(".") else f".{cleaned}"


def classify(path: Path) -> str:
    suffix = path.suffix.lower()
    if not suffix:
        return "sin_extension"
    return CATEGORIES.get(suffix, "otros")


def iter_files(directory: Path, recursive: bool):
    candidates = directory.rglob("*") if recursive else directory.iterdir()
    for candidate in candidates:
        if candidate.is_file():
            yield candidate


def run_classify(args: argparse.Namespace) -> int:
    result = {
        "archivo": str(args.file),
        "extension": args.file.suffix.lower() or None,
        "categoria": classify(args.file),
    }

    if args.json:
        print(json.dumps(result, ensure_ascii=False, indent=2))
    else:
        print(f"Archivo: {result['archivo']}")
        print(f"Extensión: {result['extension'] or 'ninguna'}")
        print(f"Categoría: {result['categoria']}")

    return 0


def run_analyze(args: argparse.Namespace) -> int:
    files = []

    for path in iter_files(args.directory, args.recursive):
        if args.extension and path.suffix.lower() != args.extension:
            continue
        files.append(path)

    extension_counts = Counter(
        path.suffix.lower() or "sin_extension" for path in files
    )
    category_counts = Counter(classify(path) for path in files)
    total_bytes = sum(path.stat().st_size for path in files)

    result = {
        "directorio": str(args.directory),
        "recursivo": args.recursive,
        "filtro_extension": args.extension,
        "numero_archivos": len(files),
        "tamano_total_bytes": total_bytes,
        "por_extension": dict(sorted(extension_counts.items())),
        "por_categoria": dict(sorted(category_counts.items())),
    }

    if args.json:
        print(json.dumps(result, ensure_ascii=False, indent=2))
    else:
        print(f"Directorio: {result['directorio']}")
        print(f"Archivos encontrados: {result['numero_archivos']}")
        print(f"Tamaño total: {result['tamano_total_bytes']} bytes")
        print("Categorías:")
        for category, amount in result["por_categoria"].items():
            print(f"  {category}: {amount}")

    return 0


def build_parser() -> argparse.ArgumentParser:
    parser = argparse.ArgumentParser(
        prog="archivo_cli.py",
        description=(
            "Analiza un directorio o clasifica un archivo "
            "según su extensión."
        ),
    )

    subparsers = parser.add_subparsers(
        dest="command",
        required=True,
        metavar="COMANDO",
    )

    analyze_parser = subparsers.add_parser(
        "analizar",
        help="resume los archivos de un directorio",
        description="Cuenta y agrupa los archivos de un directorio.",
    )
    analyze_parser.add_argument(
        "directory",
        metavar="DIRECTORIO",
        type=existing_directory,
        help="directorio que se quiere analizar",
    )
    analyze_parser.add_argument(
        "-r", "--recursive",
        action="store_true",
        help="incluye el contenido de los subdirectorios",
    )
    analyze_parser.add_argument(
        "-e", "--extension",
        type=extension_value,
        help="limita el análisis a una extensión, por ejemplo pdf",
    )
    analyze_parser.add_argument(
        "--json",
        action="store_true",
        help="devuelve el resultado en formato JSON",
    )
    analyze_parser.set_defaults(handler=run_analyze)

    classify_parser = subparsers.add_parser(
        "clasificar",
        help="clasifica un archivo según su extensión",
        description="Asigna una categoría orientativa a un archivo.",
    )
    classify_parser.add_argument(
        "file",
        metavar="ARCHIVO",
        type=existing_file,
        help="archivo que se quiere clasificar",
    )
    classify_parser.add_argument(
        "--json",
        action="store_true",
        help="devuelve el resultado en formato JSON",
    )
    classify_parser.set_defaults(handler=run_classify)

    return parser


def main(argv=None) -> int:
    parser = build_parser()

    try:
        args = parser.parse_args(argv)
    except SystemExit as error:
        return int(error.code)

    try:
        return args.handler(args)
    except PermissionError as error:
        print(f"Error de permisos: {error}", file=sys.stderr)
        return 3
    except OSError as error:
        print(f"Error del sistema de archivos: {error}", file=sys.stderr)
        return 4


if __name__ == "__main__":
    raise SystemExit(main())
El ejemplo solo consulta información. No mueve, renombra ni elimina archivos. clasificar utiliza la extensión para devolver una categoría orientativa, por lo que no identifica el contenido real del fichero.
Cómo funcionan ArgumentParser y add_argument
build_parser() concentra la definición de la interfaz. El objeto ArgumentParser recibe el nombre mostrado en la ayuda y una descripción general. Cada llamada a add_argument() añade una especificación. La referencia oficial de add_argument() documenta propiedades como type, action, choices, default, help y metavar.
Argumentos posicionales
directory y file no empiezan por guiones, así que son argumentos posicionales. El usuario debe proporcionarlos en el lugar previsto. Si faltan, el parser muestra el uso esperado y no ejecuta la operación.
python archivo_cli.py analizar
python archivo_cli.py clasificar
Opciones que reciben valores
--extension necesita un dato adicional. La función extension_value() transforma tanto pdf como .PDF en .pdf, de modo que la operación principal recibe un valor normalizado.
python archivo_cli.py analizar ./documentos --extension pdfFlags con action="store_true"
--recursive y --json funcionan como interruptores. Cuando aparecen, su valor es verdadero; cuando se omiten, es falso. No deben escribirse como --recursive true.
python archivo_cli.py analizar ./documentos --recursive --jsonSeparar operaciones mediante subcomandos
Cuando una utilidad realiza acciones distintas, acumular flags produce combinaciones difíciles de entender. Los subcomandos permiten que cada operación tenga su propia ayuda y sus propios argumentos:
analizarexige un directorio y admite recursividad, filtro de extensión y salida JSON.clasificarexige un archivo y admite salida JSON.
add_subparsers() crea el espacio para los comandos y cada llamada a add_parser() define uno. Con set_defaults(handler=...), cada subcomando queda asociado a su función. main() puede ejecutar args.handler(args) sin mantener una cadena creciente de condicionales.
Validar archivos y directorios con pathlib
Utilizar únicamente type=Path convertiría el texto en una ruta, pero no comprobaría que existe ni que representa el elemento esperado. Por eso el ejemplo utiliza existing_file() y existing_directory().
- Se construye un objeto
Path. - Se expande una posible referencia al directorio personal.
- Se comprueba la existencia de la ruta.
- Se distingue entre archivo y directorio con
is_file()eis_dir(). - Un fallo al consultar la ruta se convierte en
ArgumentTypeError.
La documentación de consulta de tipo y estado de pathlib recoge estas operaciones. Si la validación falla, el problema se presenta como un error del argumento en lugar de dejar que aparezca un traceback.
Esta comprobación inicial tiene un límite: no garantiza que el elemento continúe accesible durante toda la ejecución. Otro proceso podría borrar un archivo, modificar sus permisos o desconectar la unidad después de validarlo. Por eso main() también trata errores que se produzcan durante el recorrido o al consultar el tamaño de los archivos.
Crear mensajes de ayuda útiles
Una herramienta reutilizable debe explicar su uso sin obligar a consultar el código:
python archivo_cli.py --help
python archivo_cli.py analizar --help
python archivo_cli.py clasificar --help
La primera orden muestra los subcomandos disponibles. Las otras dos presentan los argumentos de la operación elegida. Los campos más importantes son:
description, para explicar el propósito del programa o subcomando.help, para resumir cada argumento.metavar, para mostrar etiquetas comprensibles comoDIRECTORIO.prog, para controlar el nombre que aparece en la línea de uso.
En este caso, prog="archivo_cli.py" coincide con la forma de invocación utilizada en la guía. Si más adelante empaquetas el proyecto como un comando instalable, podrás cambiarlo por el nombre definitivo del ejecutable.
Separar la interfaz de la lógica
La herramienta reparte sus responsabilidades entre funciones pequeñas:
build_parser()define la interfaz.checked_path()yextension_value()validan entradas.classify()contiene la regla de clasificación.iter_files()localiza los archivos.run_analyze()yrun_classify()ejecutan los casos de uso.main()coordina la ejecución y traduce fallos en estados de salida.
Esta separación permite probar classify(Path("foto.jpg")) sin simular una terminal. El parser queda como una capa de entrada y la lógica puede reutilizarse desde otros módulos.
Mensajes de error y códigos de salida
Un mensaje explica el problema a una persona. Un código de salida permite que otro programa decida qué hacer. La implementación propone este contrato:
| Código | Significado en esta herramienta | Caso |
|---|---|---|
0 | La operación terminó correctamente o se mostró la ayuda solicitada. | Analizar un directorio accesible. |
2 | El parser rechazó la invocación. | Omitir una ruta o proporcionar una ruta inválida. |
3 | Se produjo un problema de permisos durante la operación. | Perder acceso mientras se recorre un directorio. |
4 | Apareció otro error del sistema de archivos durante la operación. | La unidad deja de estar disponible durante el análisis. |
Los códigos 3 y 4 son decisiones propias de esta utilidad, no categorías universales. Si otro script empieza a depender de ellos, deberán documentarse y conservar su significado.
El bloque que captura SystemExit conserva el código generado por el parser. Cuando se ejecuta el archivo directamente, raise SystemExit(main()) entrega el valor final al sistema operativo.
En Bash y terminales habituales de Linux o macOS:
python archivo_cli.py analizar ./documentos
echo $?
En PowerShell:
python archivo_cli.py analizar .\documentos
$LASTEXITCODE
Salida para personas y salida para scripts
El formato predeterminado está pensado para leerse en la terminal. La opción --json devuelve una representación estructurada que otro programa puede procesar:
python archivo_cli.py analizar ./documentos --recursive --json
python archivo_cli.py analizar ./documentos --json > informe.json
La salida JSON debe mantenerse limpia. Si el programa imprime antes mensajes como “Procesando archivos”, el resultado deja de poder analizarse directamente. Los avisos y errores pueden enviarse a la salida de error con file=sys.stderr.
Incorporar JSON también crea un contrato. Cambiar claves como numero_archivos o modificar sus tipos podría romper scripts que consuman el resultado.
Pruebas manuales paso a paso
Prepara una carpeta con esta estructura:
prueba_cli/
├── README
├── datos.csv
├── foto.jpg
├── informe.pdf
├── notas.txt
└── subcarpeta/
└── programa.py- Ejecuta
python archivo_cli.py --helpy comprueba que aparecen los dos subcomandos. - Consulta
python archivo_cli.py analizar --helpy revisa las opciones disponibles. - Analiza
prueba_clisin recursividad.programa.pyno debería aparecer en el recuento. - Repite la orden con
--recursivey comprueba que se incluye el archivo de la subcarpeta. - Utiliza
--extension pdfy verifica que el filtro solo contabiliza el PDF. - Ejecuta
python archivo_cli.py clasificar prueba_cli/READMEpara comprobar el caso sin extensión. - Solicita JSON y comprueba que puede guardarse en un archivo.
- Proporciona una ruta inexistente y consulta el código de salida.
- Entrega un archivo a
analizary un directorio aclasificar. - Compara el estado de una ejecución correcta con el de una invocación inválida.
Si trabajas en Windows, puedes aislar el proyecto siguiendo la guía para crear un entorno virtual de Python en Windows. La utilidad no necesita paquetes externos, pero el entorno resulta útil si posteriormente añades herramientas de pruebas o empaquetado.
Automatizar las comprobaciones con unittest
Crea test_archivo_cli.py junto al programa:
import io
import json
import tempfile
import unittest
from contextlib import redirect_stderr, redirect_stdout
from pathlib import Path

from archivo_cli import classify, main


class ArchivoCliTests(unittest.TestCase):
    def test_classify_known_extension(self):
        self.assertEqual(classify(Path("foto.JPG")), "imagenes")

    def test_classify_without_extension(self):
        self.assertEqual(classify(Path("README")), "sin_extension")

    def test_classify_command_returns_json(self):
        with tempfile.TemporaryDirectory() as directory:
            file = Path(directory) / "informe.pdf"
            file.write_text("contenido", encoding="utf-8")

            output = io.StringIO()
            with redirect_stdout(output):
                code = main(["clasificar", str(file), "--json"])

            result = json.loads(output.getvalue())
            self.assertEqual(code, 0)
            self.assertEqual(result["categoria"], "documentos")

    def test_analyze_filters_extension(self):
        with tempfile.TemporaryDirectory() as directory:
            root = Path(directory)
            (root / "uno.txt").write_text("a", encoding="utf-8")
            (root / "dos.pdf").write_text("bb", encoding="utf-8")

            output = io.StringIO()
            with redirect_stdout(output):
                code = main([
                    "analizar",
                    str(root),
                    "--extension",
                    "pdf",
                    "--json",
                ])

            result = json.loads(output.getvalue())
            self.assertEqual(code, 0)
            self.assertEqual(result["numero_archivos"], 1)

    def test_missing_path_returns_usage_error(self):
        error_output = io.StringIO()
        with redirect_stderr(error_output):
            code = main(["clasificar", "archivo-inexistente.txt"])

        self.assertEqual(code, 2)
        self.assertIn("la ruta no existe", error_output.getvalue())


if __name__ == "__main__":
    unittest.main()
Ejecuta las pruebas con:
python -m unittest -vTemporaryDirectory proporciona un espacio aislado para cada prueba. Además, cargar la salida con json.loads() comprueba que el resultado tiene formato JSON válido. La prueba de la ruta inexistente captura stderr para evitar ensuciar la salida de la suite y verificar el mensaje esperado.
Estas pruebas se ofrecen como un procedimiento reproducible, pero el resultado debe comprobarse en la versión y el entorno concretos donde vaya a utilizarse la herramienta.
También puedes comprobar el contrato desde Bash:
#!/usr/bin/env bash

set -u

tmp_dir="$(mktemp -d)"
trap 'rm -rf "$tmp_dir"' EXIT

printf 'ejemplo' > "$tmp_dir/informe.pdf"

python archivo_cli.py clasificar "$tmp_dir/informe.pdf" --json
if [ $? -ne 0 ]; then
    echo "La clasificación válida ha fallado" >&2
    exit 1
fi

python archivo_cli.py clasificar "$tmp_dir/no-existe.pdf"
if [ $? -ne 2 ]; then
    echo "Se esperaba el código 2 para una ruta inválida" >&2
    exit 1
fi

echo "Comprobaciones completadas"
Para practicar previamente operaciones con archivos desde la terminal, está disponible este laboratorio de Bash sobre archivos, búsquedas e informes.
Errores frecuentes al crear una CLI
Leer sys.argv en toda la aplicación
Acceder directamente a posiciones de sys.argv obliga a implementar conversiones, ayuda, opciones y mensajes de error. También acopla la lógica a la terminal. Es preferible que el parser entregue datos ya convertidos a funciones normales.
Confundir conversión con validación completa
Convertir un texto en Path no demuestra que la ruta exista, sea del tipo correcto o continúe accesible durante la operación. Las comprobaciones iniciales y el tratamiento de errores de acceso resuelven momentos diferentes.
Mezclar mensajes informativos con JSON
Si --json imprime primero una frase informativa y después un objeto, la salida deja de ser directamente procesable. Reserva stdout para el resultado estructurado y utiliza stderr para avisos y errores.
Añadir operaciones destructivas sin protección
Si amplías la herramienta para mover o borrar archivos, comienza con un modo de simulación que muestre el plan sin modificar nada. Después puedes exigir una confirmación explícita. Que una orden tenga una sintaxis válida no significa que su efecto sea seguro o deseado.
Cómo evolucionar la herramienta
- Añade subcomandos cuando aparezcan operaciones claramente diferentes.
- Mantén los nombres de las opciones si otros scripts pueden depender de ellos.
- No cambies silenciosamente el significado de los códigos de salida.
- Conserva las claves JSON o introduce una estrategia de versiones.
- Añade una prueba para cada opción nueva y para sus errores previsibles.
- Empaqueta el proyecto con un punto de entrada de consola cuando quieras invocarlo sin escribir
python archivo_cli.py.
Si necesitas ejecutar la utilidad periódicamente en Windows, puedes combinarla con esta guía para programar tareas automáticas en Windows. Configura expresamente el intérprete, el script, los argumentos y el directorio de trabajo.
Checklist final para crear una CLI con argparse
- Define las operaciones y el resultado de cada una.
- Decide qué datos serán posicionales, opciones o flags.
- Utiliza subcomandos para acciones diferentes.
- Convierte y valida las entradas con funciones pequeñas.
- Representa archivos y directorios mediante
Path. - Separa la definición del parser de la lógica principal.
- Escribe ayudas que permitan usar el comando sin leer el código.
- Documenta los códigos de salida propios.
- Mantén limpia cualquier salida estructurada.
- Prueba casos correctos, límites, rutas inválidas y errores de acceso.
Esta estructura permite crear una herramienta de línea de comandos en Python con argparse sin convertir el programa en una colección de condicionales alrededor de sys.argv. El resultado es una interfaz comprensible para quien la ejecuta y una base que puede automatizarse, probarse y ampliar sin mezclar todas las responsabilidades.
Preguntas frecuentes
¿argparse necesita instalarse con pip?
No. argparse forma parte de la biblioteca estándar de Python. El ejemplo tampoco requiere dependencias externas.
¿Cuándo debo usar un argumento posicional?
Cuando el dato sea imprescindible, único y fácil de identificar por su posición. Si es opcional o modifica el comportamiento, suele encajar mejor como opción con nombre.
¿Para qué sirven los subcomandos?
Separan operaciones diferentes dentro de una utilidad. Cada subcomando puede tener sus propios argumentos, ayuda y función de ejecución.
¿Basta con comprobar que una ruta existe?
No. También hay que distinguir entre archivo y directorio y tratar los errores que puedan aparecer durante el acceso real.
¿Por qué devolver JSON además de texto?
El texto está pensado para una persona. JSON permite que otros programas consuman el resultado sin tener que interpretar frases.
¿Cómo se convierte el script en un comando instalable?
El proyecto puede empaquetarse y declarar un punto de entrada de consola. Conviene mantener una función main() que devuelva un entero y conservar la lógica separada del parser.